
L’OCR n’est que le début. L’IA le rend véritablement puissant.
- L’OCR traditionnel lit le texte
- L’OCR optimisé par l’IA comprend le contexte
- Libérez une extraction de données plus intelligente
29 juillet 2024
L’OCR (reconnaissance optique de caractères) se concentre avant tout sur la reconnaissance des caractères et la conversion des images/photos de texte en texte modifiable, tandis que l’IDP (traitement intelligent des documents) franchit un palier supplémentaire en intégrant la technologie OCR à d’autres techniques de traitement intelligent, pour automatiser tout le processus de gestion des documents et de workflow.
Avant l’OCR, il fallait taper manuellement le texte pour saisir les données dans un système informatique. Un logiciel OCR analyse les caractères d’une image, les extrait et les retranscrit en texte lisible par une machine et modifiable. L’IDP utilise l’OCR pour reconnaître les caractères, mais aussi l’intelligence artificielle (IA) et le machine learning pour lire et interpréter le texte, en extraire les informations importantes et traiter ces informations comme le ferait un humain pour effectuer un processus métier, par exemple vérifier une facture et l’envoyer pour paiement. L’IDP peut gérer une variété plus grande de contenus, y compris les informations structurées et non structurées, pour automatiser un large éventail de flux de travail (workflows) basés sur les documents ; il accompagne les entreprises dans leur transformation numérique.
Passer à :
Quelle est la différence entre l’OCR et l’IDP ?
OCR signifie optical character recognition. (reconnaissance optique de caractères). La technologie OCR est utilisée pour analyser, lire et extraire le texte tiré de scans ou d’images et le rendre lisible par des machines. L’OCR est souvent utilisé pour numériser des livres et articles imprimés ou avec des processus métier dans lesquels interviennent des documents physiques comme des factures ou des reçus. Ainsi, le contenu de ce texte peut être modifié, interrogé et stocké de façon électronique. La technologie OCR est habituellement intégrée à d’autres applications, comme l’IDP, en tant qu’élément d’un plus grand ensemble pour l’automatisation intelligente.
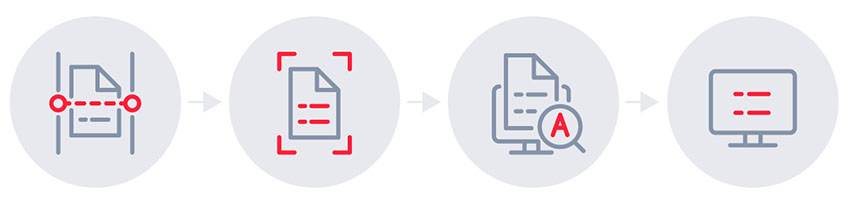
L’OCR commence par un dossier dont vous voulez extraire des informations. Il peut s’agir du scan d’un document, d’un PDF, ou encore de documents pris en photo. Les plateformes modernes d’OCR peuvent automatiquement améliorer la qualité, ajouter du contraste, et renforcer la résolution pour améliorer la justesse de la reconnaissance. Puis, des algorithmes d’OCR utilisent des modèles d’extraction déjà formés pour identifier les mots et les lignes sur une image et extraire chaque caractère reconnu.
Les données extraites sont ensuite comparées à un ensemble de modèles et de schémas prédéfinis, représentant des caractères et symboles connus. Pour ce faire, on peut avoir recours à des technologies comme le machine learning et les réseaux neuronaux, pour améliorer la précision de la reconnaissance et gérer différentes polices et différentes langues ou des mises en page compliquées comme des tableaux, des listes ou des codes-barres. Si un problème est détecté, il peut être signalé pour qu’un humain intervienne. Une fois que le processus de reconnaissance des caractères est terminé, il peut être nécessaire de vérifier d’éventuelles erreurs ou d’améliorer la précision à l’aide de la vérification orthographique, de l’analyse du contexte ou de la modélisation linguistique. Puis, le logiciel OCR produira le texte final, lisible par les machines et pouvant être intégré au système informatique de votre entreprise.
L'OCR est une technologie essentielle pour chaque secteur d’activité où l’on traite beaucoup de documents, qu’il s’agisse du travail quotidien des employés avec des documents, de la numérisation d’archives, ou de la création de répertoires numériques accessibles, en traitant de grandes quantités de documents, par exemple des lots de documents de soins ou de logistique.
Les entreprises peuvent tirer avantage des outils OCR de nombreuses façons.
Parmi les exemples habituels d’utilisation de l’OCR, il y a l’usage qu’en font des entreprises pour faciliter leur conformité au droit civil et au droit du travail, en convertissant de grandes quantités de documents papier et numériques en formats accessibles et interrogeables ; les cabinets juridiques qui convertissent des contrats papier en formats numériques, modifiables et interrogeables pour l’eDiscovery (investigations en ligne) ainsi que pour l’analyse de données ; les entreprises de santé qui transfèrent les dossiers des patients dans leurs systèmes informatiques pour être en conformité avec la norme HIPAA ; les bibliothèques et les archives qui conservent des documents historiques en format numérique. Tout cela permet aux employés d’une structure donnée d’effectuer leurs différentes tâches quotidiennes liées à des documents de façon efficace, aux développeurs de logiciels de créer des services de contenu, des archives numériques, des systèmes de gestion des documents (DMS), des solutions ECM (pour la gestion des contenus dans l’entreprise), et bien d’autres.
Le traitement intelligent des documents (IDP) permet de traiter directement les documents en capturant, extrayant et traitant automatiquement les données contenues dans les documents de l’entreprise, et ce pour quasiment n’importe quel processus, dans n’importe quel secteur d’activité.
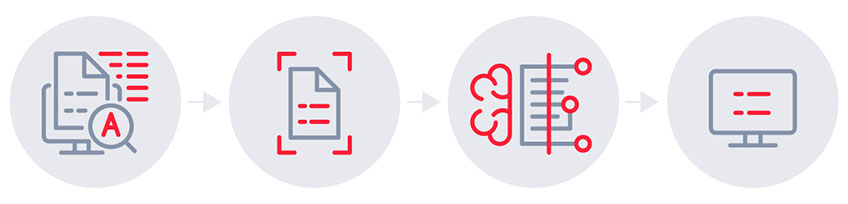
L’IDP utilise la reconnaissance optique de caractères (OCR) pour convertir du texte imprimé ou manuscrit en texte dactylographié/lisible par des machines. L’IDP utilise également des techniques d’intelligence artificielle (IA) et de machine learning (ML) pour lire, comprendre et traiter les données structurées, semi-structurées ou non structurées contenues dans des documents, comme le ferait un humain.
L’IDP utilise des modèles de machine learning pour classer les documents en différentes catégories, en fonction de leur contenu, de leur mise en page, ou d’autres caractéristiques. Par exemple, les factures peuvent être classées comme « factures », les contrats comme « contrats », etc.. Les documents ainsi classés sont ensuite envoyés à des modèles d’extraction déjà entraînés qui analysent et comprennent les données au sein d’un document à la façon d’un humain, et qui sont capables d’en extraire les informations essentielles pour l’activité de l’entreprise. Ces données peuvent être validées en fonction de règles spécifiques ou, par exemple, en les comparant à la base de données client de l’entreprise. Si un problème survient, il peut être signalé pour intervention humaine. Ce feedback dit « HITL » (avec un humain dans la boucle) améliore les modèles d’extraction, lesquels apprennent et s’améliorent en permanence grâce à ces corrections manuelles.
Grâce au recours au traitement du langage naturel (NLP), cette technologie est également capable d’interpréter le contexte des informations qu’elle lit. Par exemple, est-ce que le mot « jaguar » fait référence à un gros chat ou à une voiture ? Ou bien le mot « Rose » fait-il référence à une personne ou à une fleur ? Grâce au NLP, un niveau sans précédent de reconnaissance des données non structurées est atteint et les données sont identifiées et extraites ; cela fonctionne comme un cerveau humain, s’adaptant rapidement à l’évolution des données entrantes et générant les meilleurs résultats possibles. Ce niveau de pointe de la technologie est appelé automatisation intelligente ou hyper automatisation.
Cette plateforme IDP peut être facilement intégrée à toute une série de différents systèmes de gestion comme ERP ou CRM. Grâce aux nouvelles plateformes low-code / no-code, les « citizen developers » peuvent déployer la technologie IDP en quelques jours, sans avoir besoin d’une importante assistance, ni d’une importante maintenance informatique côté client.
Dans tous les secteurs d’activité, les entreprises subissent la pression de devoir faire plus – et plus vite – avec moins de ressources qualifiées. Elles se concentrent sur l’amélioration de l’expérience pour les clients et pour les employés et y voient la clef de l’amélioration de leur chiffre d’affaires, de leurs marges et de la fidélisation. Le traitement intelligent des documents (IDP) présente des avantages importants sur les deux aspects, en permettant aux entreprises de réussir leur transformation numérique.
La technologie IDP reflète fidèlement la façon dont les humains comprennent et gèrent les documents, faisant gagner du temps et de l’argent tout en réduisant les risques d’erreurs coûteuses.
Les principaux avantages de l’IDP comprennent :
L’OCR existe depuis longtemps et est connue en tant que technologie liée à la capture de données. L’OCR existe depuis longtemps et est connue en tant que technologie liée à la capture de données.
Cette technologie est habituellement utilisée pour numériser les documents imprimés et les rendre accessibles électroniquement ; par exemple, une lettre scannée qui peut être uploadée pour modifier le nom et l’adresse du destinataire. Cependant, l’OCR ne comprend pas la signification du texte. L’OCR ne fait que se concentrer sur la reconnaissance de caractères.
L'IDP, au contraire, intègre plus de fonctionnalités et de technologies, ce qui le rend plus intelligent. Non seulement l’IDP utilise l’OCR pour reconnaître les caractères, mais il intègre aussi l’intelligence artificielle (IA) et le machine learning pour lire le texte et le comprendre Non seulement l’IDP utilise l’OCR pour reconnaître les caractères, mais il intègre aussi l’intelligence artificielle (IA) et le machine learning pour lire le texte et le comprendre
Par exemple, il peut lire une facture, en extraire le contenu pour le comparer au bon de commande correspondant, comparer les montants pour en vérifier la justesse, puis la transmettre au directeur financier pour paiement. L’IDP peut gérer des documents complexes et traiter des données structurées, semi-structurées ou non structurées, comme le ferait un humain. Il apprend également de ses erreurs via le machine learning.
| OCR | IDP | |
| Que fait-il | « Lit » les scans et photos de documents et les convertit en documents et/ou textes lisibles par les machines et interrogeables. | Extrait les données importantes des documents structurés (formulaires), semi-structurés et non structurés, pour alimenter l’automatisation intelligente. |
| Comment cela fonctionne-t-il | Applique des algorithmes d’IA pour transformer des documents papier analogues en texte numérique, y compris la structure et la segmentation du document (texte, images, tableaux, codes-barres, cases à cocher, signatures, lignes, caractères, polices, taille de police, langue, etc.). | Utilise l’intégralité du texte fourni par l’OCR comme base et y applique l’IA, le NLP, le ML, des expressions habituelles et des règles pour comprendre les informations du document et en extraire les données étiquetées significatives qui peuvent être transmises aux applications de l’entreprise en aval pour une prise de décision éclairée. |
| Technologie | Amélioration de l’image, Détection des objets, OCR / ICR |
|
| Exemples-types d’utilisation | Met à disposition un texte lisible par les machines comme base pour : la conversion en PDF et l’archivage numérique / la recherche eDiscovery et la recherche de pointe / les techniques scientifiques numériques et l’analyse de données avec le traitement intelligent des documents (IDP) | Automatisation de tout processus métier centré sur les documents : automatisation de la comptabilité fournisseur, onboarding client / KYC, traitement des prêts, automatisation des documents de transport et de logistique, traitement des sinistres dans l’assurance |
Le traitement automatisé des factures est considérablement plus rapide que leur traitement manuel — jusqu’à 81% plus rapide. Cela se traduit par moins de paiements tardifs et plus d’occasions de profiter de remises pour paiement anticipé. Cela accélère aussi les procédures d’audit. Par exemple, la société internationale de vente en gros, Metro AG, a été en mesure de réduire de 90% la durée du cycle de traitement de ses factures.
Chaque secteur d’activité a tout un éventail de formulaires à traiter. Dans le secteur de l’assurance, il peut s’agir de déclarations de sinistre ; dans la logistique, des journaux de bord des chauffeurs ou des bons de livraison ; et dans le secteur bancaire, de demandes de cartes de crédit ou de prêts et d’hypothèques. L’automatisation des formulaires se traduit par une baisse du temps consacré à la lecture, au traitement et au transfert des informations vers le processus du workflow (flux de travail).
Cela élimine la saisie manuelle des données, coûteuse, chronophage et sujette aux erreurs, cela améliore la performance et l’efficacité.
Des recherches indiquent que 90% des organisations observent que de potentiels clients abandonnent leur processus d’inscription en ligne (onboarding) et que, en tête de leurs plaintes, ils indiquent que cela prend trop de temps et qu’il y a trop de données à saisir.
Grâce au traitement intelligent des documents, vous pouvez éliminer les goulots d’étranglement qui entraînent ces abandons. Les entreprises peuvent profiter de la technologie IDP pour la preuve de l’identité et la confirmation de l’identité, ce qui facilite la tâche aux clients et sécurise les choses pour les entreprises. L’IDP peut capturer et catégoriser les pièces d’identité, telles que les permis de conduire ou les passeports, ou des pièces justificatives, comme des relevés bancaires ou des factures, demandées pour prouver son adresse. Par exemple, il peut être utilisé par le service des cartes grises pour le renouvellement d’un permis de conduire ou par une banque pour des demandes de prêts.
L’OCR peut parfois être pris, à tort, pour une plateforme d’IDP, alors que, de fait, l’IDP a bien plus de fonctionnalités. . L’OCR se concentre avant tout sur l’extraction du texte issu d’images et de documents afin que ce texte puisse être transféré et modifié sur un écran d’ordinateur. Il reconnaît différentes polices, images, notes manuscrites et les retranscrit en texte numérique, modifiable et interrogeable. Pour les entreprises en quête de solutions d’archivage numérique ou de technologies d’assistance, lesquelles nécessitent d’excellentes fonctionnalités de reconnaissance de texte, de conversion en PDF, et de capture des données, une solution OCR est la mieux adaptée. Vous pourrez profiter d’excellentes fonctionnalités de capture de documents avec le Kit de développement logiciel OCR ABBYY (SDK).
L’IDP englobe la technologie OCR, mais franchit une étape supplémentaire en analysant et interprétant le texte comme le ferait un humain. Il utilise des technologies de pointe comme le traitement du langage naturel, le machine learning et l’intelligence artificielle pour comprendre le contenu des documents de façon plus exhaustive. L’IDP ne consiste donc pas uniquement à extraire le texte, mais à fournir une compréhension du contexte, à valider les données, et à prendre des décisions basées sur les informations trouvées. L’IDP convient mieux aux entreprises ayant besoin d’un traitement élaboré des documents, d’automatiser les workflows et de prendre des décisions basées sur le contenu. Désormais, grâce aux solutions low-code / no-code, comme ABBYY Vantage, les entreprises peuvent utiliser l’IDP, soit prêt à l’emploi avec des modèles de traitement des documents pré-entraînés et immédiatement utilisables, soit en créant rapidement et facilement leurs propres modèles d’extraction basés sur des types de document ou des besoins propres à leur activité.
Oui, l’OCR est un élément fondamental de nombreux systèmes d’IDP, en particulier lorsque l’on a affaire à des documents scannés ou pris en photo, car l’OCR peut lire les images de texte (comme des documents scannés ou des photos de texte manuscrit).
Si l’OCR aide à extraire le texte et les données des documents, c’est ensuite avec l’IDP que les informations sont traitées et analysées par des algorithmes d’IA pour effectuer des tâches telles que la validation des données, l’automatisation de la saisie des données, la classification des documents, l’apprentissage continu grâce au feedback, et d’autres.
L’IDP va au-delà de la reconnaissance basique de caractères. Il associe l’OCR à des techniques d’IA de pointe, comme le traitement du langage naturel (NLP) et le machine learning, pour comprendre le contenu et le contexte du document. Cela permet à l’IDP d’extraire non seulement le texte, mais aussi sa signification et les liens entre les différents éléments du document.
Voici quelques-uns des avantages de l’IDP par rapport à l’OCR :
Plus grande justesse de l’extraction : si l’OCR se concentre sur la conversion d’images de texte en texte lisible par des machines, l’IDP, lui, permet de gagner en précision en croisant les données extraites avec les bases de données, les dossiers précédents et les informations contextuelles. Cela réduit les erreurs dans l’extraction et l’interprétation des données.
Données structurées et non structurées : l’IDP est capable de traiter tant les données structurées que non structurées. Il peut traiter des formulaires, des tableaux, des factures, des contrats et d’autres types de documents, en extrayant les données en format structuré. L’OCR, pour sa part, convient mieux pour une extraction simple de tout le texte figurant sur des images.
Flux de travail automatisés : l’IDP peut être intégré à des workflows et processus métier automatisés. Il peut effectuer des tâches telles que la classification des documents, l’extraction, la validation, et le routage des données. Cela réduit ainsi le besoin d’intervention manuelle. Cela peut se traduire par une efficacité accrue et des temps de traitement réduits.
Adaptabilité et apprentissage : les systèmes IDP apprennent en permanence des interactions avec les utilisateurs et de leur feedback – il s’agit de l’apprentissage « HITL » (avec un humain dans la boucle). Au fil du temps, ils peuvent améliorer leur précision et leur compréhension de types spécifiques de documents, et s’adapter aux changements de formats et de structures des documents et des contenus.
Types de documents complexes : l’IDP intègre plus de fonctionnalités de traitement des documents et peut gérer ceux dont la structure est complexe, lorsque l’extraction des données nécessite de comprendre les relations entre les différentes informations. Cela comprend les documents dans plusieurs langues et formats ou dont la mise en page varie.
Conformité réglementaire : l’IDP peut aider les entreprises à garantir leur conformité aux normes réglementaires, en extrayant avec précision et en gérant les informations essentielles des documents juridiques, des contrats et des formulaires de conformité. Ces informations peuvent ensuite être confrontées à des règles prédéfinies par l’entreprise.
Le traitement des images est utilisé en tant qu’étape préliminaire de l’OCR, pour préparer l’image à une extraction optimale du texte, par exemple en éliminant les mouchetures ou les filigranes, ou encore en adaptant la luminosité et le contraste afin d’obtenir une image plus nette. Le traitement des images peut également comprendre l’extraction de certaines caractéristiques, la détection de certains objets ou l’exécution de certaines transformations pour rendre les images plus utiles à des applications spécifiques.
La Robotic Process Automation cognitive (RPA cognitive) fait référence à l’intégration de la technologie RPA à des fonctionnalités cognitives comme l’intelligence artificielle (IA), le machine learning (ML), le traitement du langage naturel (NLP), et la reconnaissance optique de caractères (OCR). On appelle également cela automatisation intelligente.
Les technologies OCR (reconnaissance optique de caractères) et IDP (traitement intelligent des documents) jouent un rôle essentiel dans l’amélioration des fonctionnalités cognitives des systèmes RPA. L’IDP permet à ces derniers, non seulement d’extraire les données des documents, mais aussi de comprendre le contexte et la signification des informations. Cette excellente capacité de traitement permet aux « bots » de RPA d’effectuer des tâches plus complexes, à la façon des humains, comme de traiter des documents non structurés ou semi-structurés, plus intelligemment. Par exemple, un « bot » de RPA doté de l’IDP est en mesure d’extraire les données d’une facture, d’en valider les informations selon des règles prédéfinies par l’entreprise, et de prendre des décisions basées sur le contenu extrait ; ou bien il peut analyser un contrat juridique pour en identifier les termes-clés, les obligations et les échéances.

Slavena Hristova
Directrice du Marketing Produit, groupe Vantage chez ABBYY
Slavena Hristova est Directrice du Marketing Produit pour Vantage chez ABBYY. Elle dirige le marketing produit international pour la ligne de produits ABBYY Vantage. Elle supervise l’ensemble du cycle de vie du produit, depuis l’analyse des demandes du marché à la stratégie de lancement sur le marché, en passant par les outils d’aide à la vente, ou le catalogue de formation pour les partenaires du réseau. Elle a plusieurs années d’expérience dans la gestion de produits et le marketing, dans les domaines de la reconnaissance de texte, de la gestion des informations et des documents.
Connectez-vous avec Slavena sur LinkedIn.